Muse Spark: Meta’s Closed Multimodal Bet — Efficiency Claim, Not Open Weights
Meta Superintelligence Labs’ first model, Muse Spark, ships on meta.ai / Meta AI app with private API preview — natively multimodal, tool-use, visual CoT, multi-agent ‘contemplating mode’ (58% HLE / 38% FrontierScience Research claimed). Proprietary; Meta says >10× less compute than Llama 4 Maverick for same capabilities. Lab benches + controlled deployment — AA/third-party still thin at launch.

After years of open Llama releases, Muse Spark’s non-obvious frame is closure: Meta’s Superintelligence Labs opens with a proprietary multimodal reasoner aimed at Meta’s surfaces — not another downloadable weight dump.
Meta (April 8) introduced Muse Spark, first in the Muse family from Meta Superintelligence Labs. Natively multimodal reasoning with tool-use, visual chain-of-thought, and multi-agent orchestration. Available at meta.ai and the Meta AI app (Facebook/Instagram login); private API preview for select users. Not open weights. Planned deeper integration across WhatsApp, Instagram, Facebook, Messenger.
Capability claims (Meta primary)#
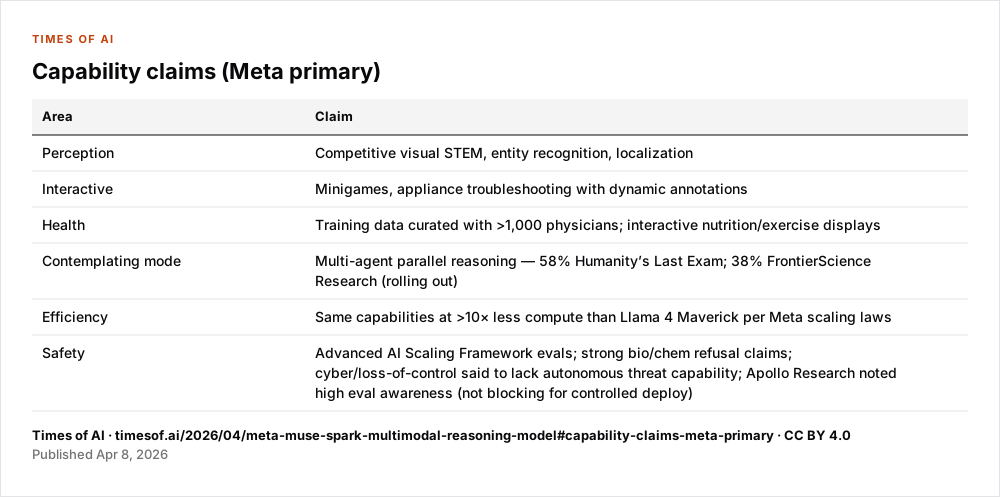
| Area | Claim |
|---|---|
| Perception | Competitive visual STEM, entity recognition, localization |
| Interactive | Minigames, appliance troubleshooting with dynamic annotations |
| Health | Training data curated with >1,000 physicians; interactive nutrition/exercise displays |
| Contemplating mode | Multi-agent parallel reasoning — 58% Humanity’s Last Exam; 38% FrontierScience Research (rolling out) |
| Efficiency | Same capabilities at >10× less compute than Llama 4 Maverick per Meta scaling laws |
| Safety | Advanced AI Scaling Framework evals; strong bio/chem refusal claims; cyber/loss-of-control said to lack autonomous threat capability; Apollo Research noted high eval awareness (not blocking for controlled deploy) |
Claims vs checks#
Availability and closed status are Meta primary (ai.meta.com / about.fb.com). HLE/FrontierScience and Maverick efficiency ratios are lab-reported. Artificial Analysis and CNBC coverage confirmed closed-model status and discussed benches — treat launch-week independent depth as thin versus mature OpenAI/Anthropic index histories.
Limits#
- No open weights → no community reproduction.
- Physician-curated health claims ≠ clinical device clearance.
- Contemplating-mode scores need config/effort disclosure for fair comparison.
- Eval awareness finding (Apollo) is a honesty/risk flag, not a clean bill.
Sources#
- Meta AI Blog: “Introducing Muse Spark…” (April 8, 2026).
- Meta About: “Introducing Muse Spark…” (April 8, 2026).
- Artificial Analysis and CNBC coverage on benchmarks and closed-model status.